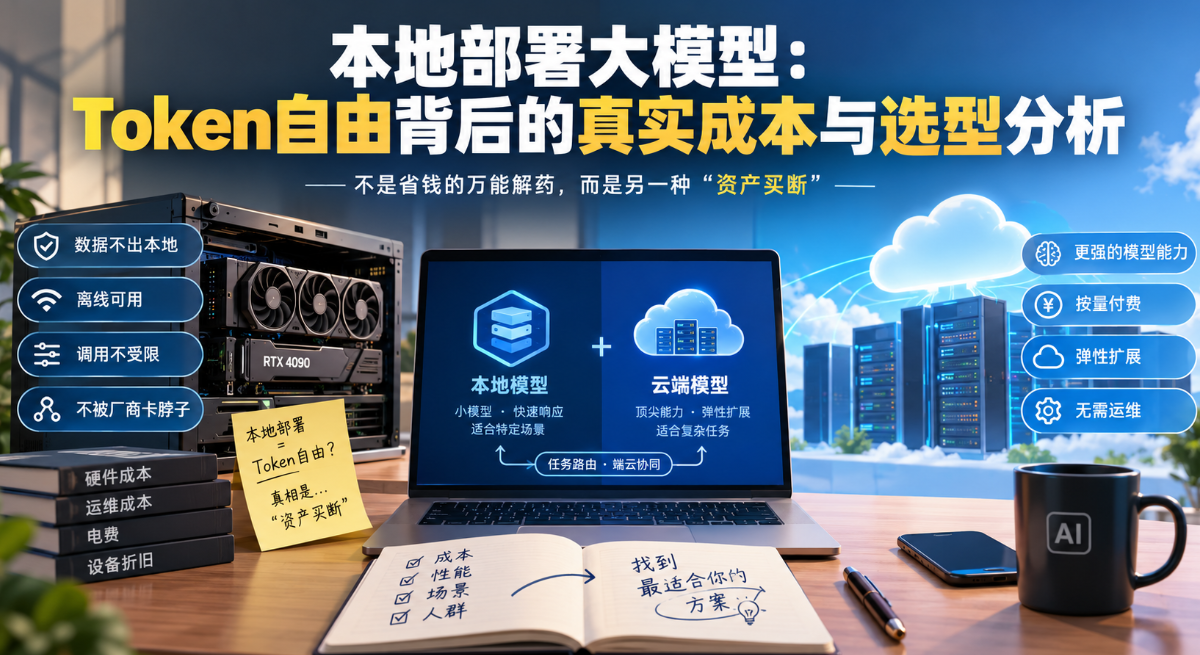
在 AI 大模型快速迭代的今天,“本地部署大模型 = Token自由”的说法吸引了大量技术爱好者与开发者。名义上,本地模型部署完成后,每一次推理都不再需要按次付费,边际成本确实趋近于零。然而,许多人忽视了其本质是将“按量付费”变为了高昂的“资产买断”。
一、“Token自由”的真相:零边际成本背后的“资产买断”陷阱
1.1 逃离 API 付费,却撞上了高昂的硬件壁垒
很多人选择本地部署的初衷是为了规避昂贵的云端 API 费用。然而,正是全球爆发的 AI 算力需求推动了显存与内存价格暴涨。生产 HBM 产能直接挤占了消费级 DDR5 与显存晶圆,导致高容量 DDR5 套装价格明显上涨,显存也已成为高显存显卡物料成本中的重要组成部分。
硬件市场的门槛极高:
- 消费级入门设备:如 RTX 4090 或 RTX 5090,整机价格通常达到数万元。
- 长上下文与高质量推理设备:跑起具备长上下文或高质量推理能力的开源大模型,需要更大容量内存或显存资源,高端设备投入可能达到 数万元至十万元级别。
- 顶级开源满血大模型:若想在本地运行数百 B 参数级别的大型开源模型,需要多张高端专业算力卡以及相应的服务器、供电和散热基础设施,整体投入可能达到数十万甚至数百万元人民币。
1.2 回本周期与 ROI 深度算账
本地部署是否划算,关键取决于对比对象与设备利用率。以下为不同基准下的硬件 ROI 与回本周期示意:
| 对比服务类别 | 代表性模型 / API 方案 | 设备利用率 30% 下的回本周期 | 经济性选型分析 |
|---|---|---|---|
| 顶尖闭源 API | Opus / GPT-5 前沿模型 | 约 0.3 个月 | 仅当本地小模型能力能够满足复杂需求时,本地部署才具有明显经济意义 |
| 中端闭源 API | 商业主流中端模型 API | 约 1.6 个月 | 高使用频率、长期稳定负载下,购买硬件具备一定经济可行性 |
| 小型开源 API | $0.30/百万 Token 低价托管 API | 约 63 个月(5.2 年) | 对低频个人用户而言,直接调用云端 API 往往更加经济 |
低利用率陷阱:如果个人设备日利用率长期低于 10%,硬件成本的回收周期可能延长至 2~4 年甚至更久。此外,每天持续运行产生的功耗也会形成长期电费支出。若进一步考虑设备折旧、升级以及显存容量不足导致的性能损失,低利用率情况下,本地部署并不一定能够节省实际成本。
二、“能跑”不等于“能干活”:本地大模型的性能与物理约束
在很多网络测评中,几 GB 的小模型可以快速完成对话,让人误以为本地部署已经可以完美承担生产任务。
然而,工程实践中,“能跑 Demo”和“生产级出活”之间存在明显差距。
2.1 显存悬崖与内存带宽瓶颈
LLM 推理高度依赖内存与显存带宽,因此会出现明显的**“显存悬崖”**现象:
- 权重全部载入显存:推理速度可能达到 40~50 tok/s,交互体验较为流畅。
- 溢出至系统内存:速度可能急剧下降至 1~2 tok/s,在实际生产环境中基本失去高效率使用价值。
可以简单理解为:
模型本身拥有不错的能力,但硬件带宽不足会让理论上的模型性能无法转化为实际生产效率。
此外,如果开启长上下文或者处理多并发请求,KV Cache 会迅速占用剩余显存。一旦并发数持续增加,推理延迟可能显著上升,甚至直接触发显存不足(OOM)。
2.2 智能上限与复杂任务断崖
目前开源模型进步非常快,部分新一代模型已经拥有较强的代码、推理和文本处理能力。
但在实际应用中,消费级硬件通常更适合运行 7B~30B 左右的量化模型。这类模型在不同任务上的表现存在明显差异:
- 简单结构化任务(表现优秀):固定格式文本处理、摘要分类、JSON 数据提取、公文套路写作等窄任务,本地模型通常可以提供不错的表现,并且响应速度快。
- 复杂开放性任务(容易出现性能下降):复杂多文件 Agent 编程、长链条自主推理、复杂项目重构以及高度开放式创作等场景,对模型能力与上下文管理要求更高,本地小模型更容易出现幻觉、推理中断或陷入重复思考。
因此,要让本地小模型稳定承担生产任务,通常需要更加严格的 Prompt、上下文管理、任务拆分以及工作流约束。
三、谁真正需要本地部署?六种适用场景与五类避坑人群
既然“本地部署实现完全 Token 自由”在多数场景下并不意味着绝对省钱,那么真正适合本地部署的用户主要集中在以下几类。
3.1 适合本地部署的 6 类场景
| 序号 | 场景类型 | 核心需求与匹配优势 |
|---|---|---|
| 1 | 数据敏感与合规要求 | 医疗病历、法务合同、涉密公文、财务账目等不适合上传云端的数据,本地部署可以减少数据离开本地环境的需求 |
| 2 | 高频 + 长期生产负载 | 设备利用率长期保持在较高水平,并且存在持续、大吞吐量的自动化任务 |
| 3 | 固定套路化工作 | 通知、汇报、总结、分类、批处理等模板化任务,对模型的创造性要求相对较低 |
| 4 | 离线与内网物理隔离 | 无法访问外网 API,或者业务环境本身要求与互联网隔离 |
| 5 | 专用开源多媒体生成 | 动画、图像、音视频、语音合成以及其他适合本地部署的开源模型,可以降低持续调用云服务的成本 |
| 6 | 已有闲置高配置硬件 | 显卡、内存和整机等成本已经支付,新增 AI 任务的边际成本较低 |
3.2 更适合直接使用云端 API 的 5 类人群
| 序号 | 人群分类 | 主要原因与选型建议 |
|---|---|---|
| 1 | 低频使用者(利用率 < 10%) | 如果实际调用频率很低,按量付费通常比专门购买高端硬件更容易控制成本 |
| 2 | 追求顶尖模型能力与最新能力 | 前沿编程、深度科研、复杂逻辑和高难度推理任务,对模型能力要求较高 |
| 3 | 多用户高并发场景 | 本地单机的显存与带宽存在明确上限,需要根据并发量配置更多硬件 |
| 4 | 没有运维精力的普通用户 | 驱动、CUDA、量化格式、显存管理、OOM 排查等都可能产生额外维护成本 |
| 5 | 预算有限的个人开发者 | 在预算较低的情况下,消费级设备未必能够提供与顶级云端模型相匹配的生产效率 |
四、破解之道:端云协同与“任务路由”混合架构
面对本地算力与云端能力之间的差异,越来越实用的一种方案是采用**“端云协同 / 任务路由”混合架构**。
- 端侧 / 本地模型做“侦察员”与“过滤网”:负责处理敏感数据、简单格式转换、即时响应以及高度标准化的小任务。
- 云端高级模型做“思考大脑”:当任务路由系统检测到高复杂度、长链条代码重构或者深度推理需求时,再将任务交给能力更强的云端模型。
这种方式可以在本地模型和云端模型之间进行分工:
简单任务留在本地,复杂任务交给云端。
这样既可以保留本地部署在隐私、响应速度以及离线环境方面的优势,又能避免为了偶尔出现的复杂任务购买昂贵且容易过时的高端硬件。
五、总结与选型建议
“本地部署大模型”并不是省钱的万能解药,更像是在为自己购买一台**“私有发电机”**。
它真正带来的价值并不只有免费 Token,更重要的是:
- 数据不出本地
- 调用不受单次请求限制
- 离线可用
- 能够自主选择模型
- 减少对单一厂商服务的依赖
- 可以根据自身业务定制推理环境
对于绝大多数个人和中小企业而言,不必单纯为了追求“Token自由”而盲目购买高端硬件。
更加实际的思路是:
先验证需求,再决定算力。
可以先通过云端 API 或现有设备测试真实使用频率、任务类型和模型能力要求。当业务吞吐量、隐私要求或者离线需求达到一定程度后,再针对具体任务配置本地硬件。
最终需要考虑的并不是“本地还是云端谁一定更好”,而是:
你的任务需要什么能力、每天使用多少、数据是否允许上云,以及你愿意承担多少硬件和运维成本。